
รับมือบอท AI ดูดวิชา: วิธีตั้งค่า robots.txt และ llms.txt
เผยยุทธวิธีรับมือบอท AI ที่แห่กันมาดูดข้อมูลหน้าเว็บจนเซิร์ฟเวอร์สะเทือน พร้อมวิธีตั้งค่า robots.txt และสร้าง llms.txt เพื่อจัดระเบียบการเรียนรู้ของโมเดลอย่างมีชั้นเชิง
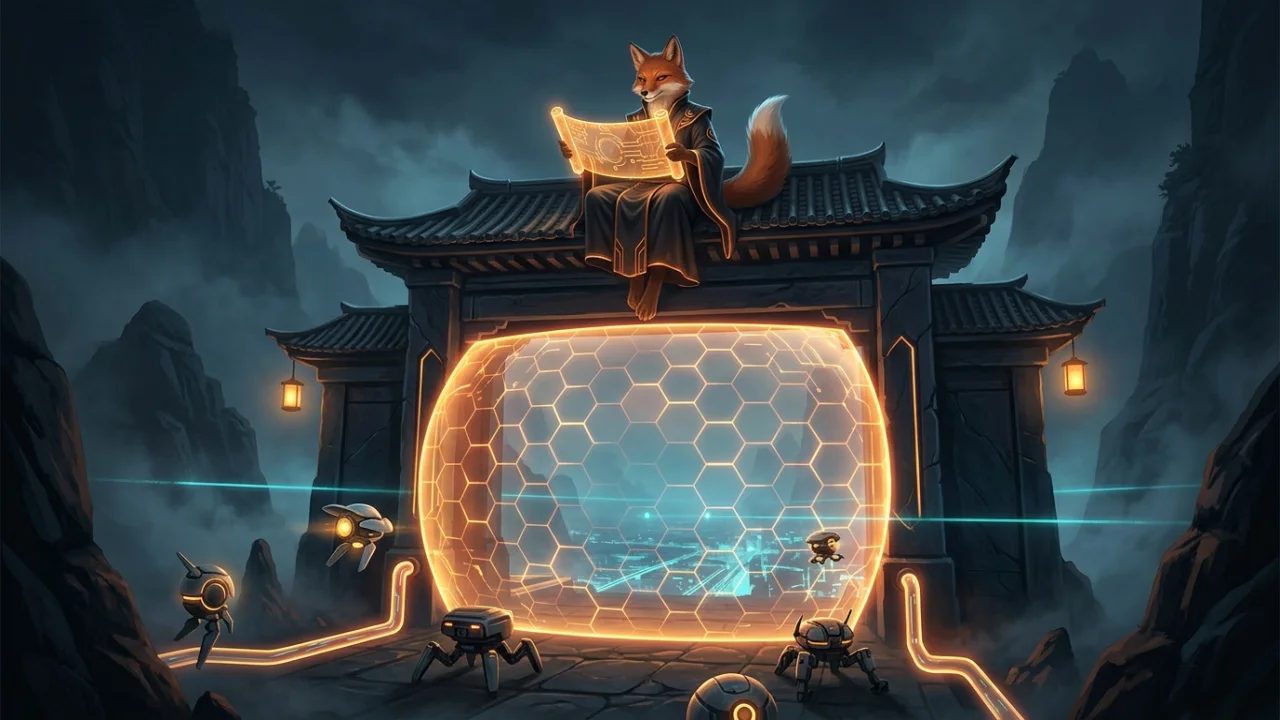
หากท่านเป็นผู้ดูแลเว็บไซต์ที่คอยเฝ้ามอง Server Log อยู่เป็นประจำ ในช่วงปี 2025–2026 นี้ ท่านอาจสังเกตเห็นปรากฏการณ์ประหลาดที่เกิดขึ้นในความเงียบ: Traffic ของเว็บไซต์พุ่งสูงขึ้นอย่างก้าวกระโดด แต่ยอดผู้ชมที่เป็นมนุษย์กลับเท่าเดิม!
เมื่อซูมเข้าไปดู User-Agent ของแขกผู้มาเยือน จะพบชื่อที่ไม่คุ้นเคยแต่คุ้นหูในวงการเทคโนโลยี:
GPTBot(OpenAI)ClaudeBot/anthropic-ai(Anthropic)Bytespider(ByteDance / TikTok)CCBot(Common Crawl)Google-Extended(Google AI Training)PerplexityBot(Perplexity AI)
กองทัพ "หุ่นยนต์และบอท AI" จากทั่วทุกสารทิศ กำลังออกลาดตระเวนท่องไปทั่วยุทธภพอินเทอร์เน็ต เพื่อดูดกลืนบทความ ข้อมูลเชิงลึก และภูมิปัญญาบนหน้าเว็บไปฝึกฝนและป้อนให้สมองกลขนาดยักษ์
สำหรับเว็บขนาดใหญ่ที่มี Server คลัสเตอร์ระดับองค์กร นี่อาจเป็นแค่คลื่นลมธรรมดา แต่สำหรับเว็บขนาดกลาง ขนาดเล็ก หรือเซิร์ฟเวอร์ VPS ขนาดกะทัดรัด การถูกบอท AI หลายสิบตัวเข้ามาสแกนอ่านพร้อมกันในเวลาเดียว อาจทำให้ CPU พุ่งแตะ 100%, RAM หมดเกลี้ยง, Bandwidth ทะลัก และทำให้หน้าเว็บโหลดช้าจนผู้ใช้จริงเข้าไม่ได้!
วันนี้สำนัก 2BFox จะพาจอมยุทธทุกท่านมาทำความเข้าใจยุทธวิธีในการ "คัดกรองแขกผู้มาเยือน"—เราจะปิดกั้นบอทเกเรอย่างไร และจะเปิดประตูต้อนรับ AI อย่างชาญฉลาดด้วยไฟล์มาตรฐานใหม่อย่าง llms.txt ได้อย่างไรบ้าง
1. ด่านแรก: สำรวจพฤติกรรมของบอท AI (รู้เขารู้เรา)
บอท AI ในปัจจุบันแบ่งออกเป็น 2 กลุ่มใหญ่ที่มีเป้าหมายต่างกัน:
- AI Training Bots (บอทดูดข้อมูลไปเทรนโมเดล): เช่น
GPTBot,Bytespider,CCBotบอทกลุ่มนี้จะกวาดเนื้อหาทุกซอกทุกมุมของเว็บเพื่อนำไปใส่ Dataset สำหรับเทรน LLM รุ่นถัดไป บอทเหล่านี้มัก Crawl ถี่และกิน Resource สูงมาก - AI Search & Retrieval Bots (บอทค้นหาเพื่ออ้างอิงแหล่งที่มา): เช่น
PerplexityBot,OAI-SearchBotบอทกลุ่มนี้เข้ามาอ่านเพื่อนำคำตอบไปสรุปให้ผู้ใช้พร้อมให้เครดิตลิงก์กลับมายังเว็บของเรา ซึ่งสร้างผลดีต่อการได้ Traffic แบบ AI Overview
เป้าหมายของเราไม่ใช่การ "ปิดประตูตีแมว" แบบตัดขาดจากโลกภายนอก 100% แต่คือการ "ตั้งด่านคัดกรอง"—อนุญาตให้บอทที่เป็นประโยชน์เข้ามาได้ และสกัดกั้นบอทที่สูบพลังงานเครื่องมากเกินความจำเป็น
2. ด่านที่สอง: ปรับจูน robots.txt ให้รัดกุม
ไฟล์ robots.txt คือหนังสือประกาศหน้าประตูค่ายกล แม้บอทเถื่อนบางตัวอาจเพิกเฉย แต่บอท AI ของบริษัทชั้นนำระดับโลกทั้งหมด เคารพกฎใน robots.txt อย่างเคร่งครัด
ตัวอย่างการบล็อกบอท AI สายสูบ Resource หนัก:
# สกัดกั้นบอทเทรนโมเดลที่ดูดข้อมูลหนัก
User-agent: GPTBot
Disallow: /

User-agent: Bytespider
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

User-agent: Google-Extended
Disallow: /

# อนุญาตให้ Search Engine หลักและบอทค้นหาอ้างอิงเข้าได้ตามปกติ
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /ข้อควรระวัง:Google-Extendedเป็นคนละตัวกับGooglebot! การบล็อกGoogle-Extendedจะบล็อกเฉพาะการนำเนื้อหาไปเทรนโมเดล โดยที่เว็บของท่านยังคงติดอันดับบนหน้าค้นหา Google Search ตามปกติ
3. ด่านที่สาม: อาวุธลับยุคใหม่ llms.txt คืออะไร?
ในปี 2024–2026 มาตรฐานใหม่ที่ชื่อว่า llms.txt ได้ถือกำเนิดขึ้นและได้รับการผลักดันอย่างรวดเร็ว
ลองจินตนาการว่า เมื่อบอท AI เปิดหน้าเว็บของเราขึ้นมา มันต้องดาวน์โหลดโค้ด HTML นับหมื่นบรรทัด, สไตล์ชีต CSS, ไฟล์ JavaScript, เมนูส่วนหัว, แบนเนอร์โฆษณา และฟุตเตอร์ เพื่อสกัดเอาข้อความเนื้อหาเพียงไม่กี่ร้อยคำ ซึ่งเป็นการสิ้นเปลืองพลังงานประมวลผลของทั้งสองฝ่าย
llms.txt คือไฟล์ Markdown สรุปสาระสำคัญของทั้งเว็บไซต์ ที่วางไว้ที่ Root ของเว็บ (เช่น https://2bfox.com/llms.txt):
- เขียนด้วยรูปแบบ Plain Markdown ที่สะอาด ไร้แท็ก HTML รกตา
- สรุปว่าเว็บไซต์นี้คืออะไร มีบริการอะไรบ้าง
- รวบรวมลิงก์ไปยังเนื้อหาสำคัญและเอกสารคู่มือหลัก
- ช่วยให้ AI ตอบคำถามเกี่ยวกับเว็บของเราได้อย่างถูกต้อง 100% โดยไม่ต้องมานั่ง Crawl ทีละหน้าให้เปลืองพลังงาน!
ในระบบ Lite Fox CMS ของเรา มีการติดตั้งระบบสร้าง llms.txt แบบไดนามิกไว้ให้ตั้งแต่แรกเกิด (ผ่าน llms_auto.php) ทำให้เมื่อมีบทความใหม่ ระบบจะสรุปรายชื่อลงสารบัญ AI ให้โดยอัตโนมัติ
4. ด่านที่สี่: การจำกัดอัตราคำขอ (Rate Limiting บน Nginx/Apache)
สำหรับบอทเถื่อนหรือ Scraping Script นิรนามที่ไม่ยอมอ่าน robots.txt การรับมือที่ดีที่สุดคือการตั้งค่าที่ระดับ Web Server:
- Nginx limit_req: จำกัดให้ IP หนึ่งๆ สามารถขอหน้าเว็บได้ไม่เกิน 5–10 requests ต่อวินาที
- Cloudflare Bot Management: เปิดใช้งานโหมด "Block AI scrapers and crawlers" ด้วยคลิกเดียวในหน้า Security
- Fail2ban: ตรวจจับ IP ที่กระหน่ำยิง Request ผิดปกติแล้วแบนชั่วคราว 24 ชั่วโมง
5. บทสรุป: จัดระเบียบเพื่ออยู่ร่วมกันอย่างสันติ
โลกของ AI กำลังเติบโตอย่างรวดเร็ว ข้อมูลบนเว็บไซต์ของพวกเราคืออาหารชั้นเลิศที่ขับเคลื่อนวิวัฒนาการนี้
เราไม่จำเป็นต้องหวาดกลัวหรือปิดกั้นตัวเองจนกลายเป็นเกาะร้าง แต่จง "เป็นเจ้าบ้านที่ฉลาด":
- ใช้
robots.txtปฏิเสธบอทที่สูบแรงเครื่องเกินพอดี - ต้อนรับบอทค้นหาที่ให้เครดิตลิงก์กลับมา
- จัดเตรียม
llms.txtเป็นสำรับอาหารจานด่วนให้ AI อ่านง่าย สบายเครื่อง
เพียงเท่านี้ เว็บไซต์ของท่านก็จะเบาสบาย ปลอดภัยจากอาการ Server สะอึก และยังคงมีตัวตนที่สง่างามในยุคแห่งปัญญาประดิษฐ์อย่างแท้จริงครับ! 🦊🌐
บทความที่เกี่ยวข้อง
คู่มือตั้งค่าความปลอดภัยเบื้องต้นให้ Linux VPS: 3 ชั้นป้องกันที่ต้องทำก่อนขึ้นระบบจริง
เพิ่งเปิดเครื่อง Linux VPS ใหม่? อย่าเพิ่งปล่อยให้เซิร์ฟเวอร์เปิดโล่ง! สรุปคู่มือ 3 ปราการด่านแรกที่ต้องทำทันที: ปิด Password หันมาใช้ SSH Keys, กางเกราะ UFW Firewall และติดตั้ง Fail2ban บล็อกบอทแฮกเกอร์อัตโนมัติ
Shared Hosting vs VPS vs Dedicated Server เทียบชัดๆ เลือกแบบไหนให้เหมาะกับเว็บไซต์คุณ
เจาะลึกความแตกต่างระหว่าง Shared Hosting, VPS และ Dedicated Server ทั้งเรื่องงบประมาณ ประสิทธิภาพ ความปลอดภัย และการดูแลระบบ เพื่อเลือกโฮสติ้งที่คุ้มค่าและตอบโจทย์เว็บคุณที่สุด
เปิดตัวเว็บไซต์ 2BFox.com โฉมใหม่ ด้วยระบบ Custom Lightweight CMS
ทำความรู้จักโครงสร้างเว็บไซต์ 2BFox.com ที่ออกแบบใหม่ทั้งหมดด้วย PHP 8.3 เน้นความเร็วสูง รองรับ Static Pages แบบแยก Section และ PWA บนมือถือ